DWS数据库底层 数据处理与存储支持服务探析
引言
数据仓库服务(Data Warehouse Service,DWS)作为企业级分析型数据库,其底层架构的设计直接决定了数据处理的效率与存储的可靠性。DWS基于Shared-Nothing架构与MPP(大规模并行处理)技术,构建了一套高效的数据处理与存储支持服务体系。本文将从数据处理流程、存储支持服务两个维度,剖析DWS数据库底层的核心机制。
一、数据处理架构:MPP并行计算引擎
DWS的数据处理核心在于其MPP并行计算引擎。整个集群由多个计算节点(Data Node)组成,每个节点独立管理自身的CPU、内存和存储资源。查询请求由协调节点(Coordinator)接收,经过SQL解析、语义分析、查询重写和基于代价的优化后,生成分布式执行计划,并将执行片段下发至各数据节点并行执行。
在数据处理层面,DWS实现了以下几项关键能力:
- 向量化执行引擎:以批量数据(Vector)为单位进行处理,相比逐行处理大幅降低了函数调用开销和CPU缓存失效,显著提升扫描、过滤、聚合等操作的吞吐量。
- 算子并行与流水线:扫描、连接、聚合、排序等算子以流水线方式组织,数据在算子间以生产者-消费者模式流动,减少中间结果的物化开销。
- 运行时动态调度:根据各节点的负载与数据倾斜情况动态调整任务分配,利用数据重分布(Redistribution)和广播(Broadcast)等机制处理连接操作中的数据分布问题。
- 列式存储与压缩感知执行:与列存格式紧密配合,执行引擎可直接对压缩数据进行部分解码,减少I/O与内存带宽压力。
二、存储支持服务:列存、行存与分层存储
DWS提供行存(Row Store)与列存(Column Store)两种存储引擎,分别面向OLTP型点查与OLAP型批量分析场景。
- 列存引擎:列存表按列独立组织数据,配合高效压缩算法(如Delta、RLE、LZ4等)显著降低存储空间与I/O量。列存支持min/max索引、字典编码等辅助结构,便于谓词下推与快速过滤。
- 行存引擎:面向高频点更新与短查询,保证事务ACID特性与低延迟访问,适用于维度表或明细追加场景,常与列存表混合使用。
- 分区与倾斜优化:支持范围、列表、哈希及多维分区,分区裁剪可在扫描阶段跳过无关数据。对于分布式表中的数据倾斜,DWS通过分布键选择、重分布与本地连接策略加以缓解。
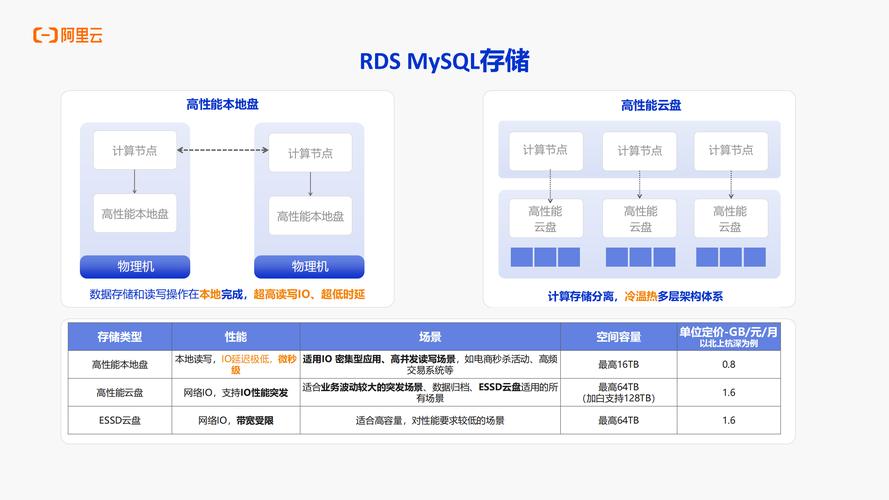
- 存储层次管理:结合SSD与HDD的分层策略,热数据存放于高速介质,冷数据下沉至大容量存储;同时支持数据生命周期管理,按时间或访问频率自动迁移。
三、事务与一致性支持
在数据处理与存储之间,DWS通过多版本并发控制(MVCC)与分布式事务机制保证一致性。写入的数据首先进入内存中的增量结构(Delta表),达到阈值后与基线数据合并(Merge),既保证写入性能,又维持列存扫描效率。分布式事务采用两阶段提交(2PC)配合全局事务管理器,确保跨节点操作的原子性;快照隔离机制使读操作无需加锁即可获得一致视图。
四、
DWS数据库底层以MPP并行计算引擎为处理核心,以行列混合存储与分层管理为存储支撑,辅以MVCC与分布式事务保证一致性,形成了一套面向大规模分析场景的高效数据处理与存储支持服务体系。理解这些底层机制,有助于在实际应用中合理设计表结构、分布策略与分区方案,从而充分发挥DWS的并行处理与存储优化能力。
如若转载,请注明出处:http://www.origspot.com/product/29.html
更新时间:2026-10-24 03:47:31