面向第一至十批绿色工厂名单匹配的数据处理与存储支持服务研究
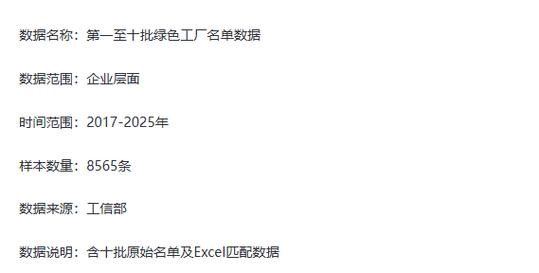
随着我国绿色制造体系建设的不断推进,工业和信息化部已先后公布十批绿色工厂名单。这些名单覆盖钢铁、化工、建材、机械、电子、轻工等多个行业,是分析区域绿色制造水平、产业链绿色化程度以及企业节能减排成效的重要基础数据。由于各批次名单发布时间跨度较长、公开格式不统一、企业名称与统一社会信用代码之间缺乏直接对应关系,如何将第一至十批绿色工厂名单与工商注册数据、能耗数据、排放数据、产业链数据等进行高效匹配,成为一项具有现实意义的技术任务。围绕这一需求,数据处理和存储支持服务应当形成从数据采集、清洗、标准化、匹配、存储到服务接口的完整能力体系。
在数据采集环节,需要系统整理第一至十批绿色工厂名单的原始信息源。这些信息通常来源于工业和信息化部官网、各省市工信部门网站、通知附件以及第三方数据平台。采集内容不仅包括企业名称、批次、所属地区、行业类别、工厂类型等基础字段,还应尽可能保留公告文号、发布时间、推荐单位等辅助信息。由于名单跨度长、附属文件多,采集过程应支持批量导入、增量更新和历史回溯,避免因重复采集或遗漏导致后续匹配失真。
数据清洗和质量控制是匹配成功的关键。绿色工厂名单中常见的问题包括企业名称简称与全称混用、集团公司与下属工厂并列出现、地区名称变更、行业分类口径差异等。数据处理服务应建立名称规范化规则,如去除括号注释、统一行政区划名称、处理“有限公司”“股份有限公司”等后缀差异,并对照权威企业数据库进行初步校验。对于无法直接确定的企业,应保留“待人工复核”标签,而不是强行匹配,以降低错误关联风险。
在标准化基础之上,核心任务是名单匹配。匹配可以分为三个层次:第一层是基于统一社会信用代码或组织机构代码的精确匹配;第二层是基于企业名称、注册地址、法定代表人等字段的规则匹配;第三层是基于文本相似度、行业特征和地区特征的模糊匹配。对于第一至十批名单而言,早期批次企业信息可能缺少统一社会信用代码,因此需要更多依赖工商登记数据库、企业年报数据库和信用中国等外部数据源。匹配服务应支持多策略组合、置信度评分和人工复核机制,保证结果可解释、可追踪。
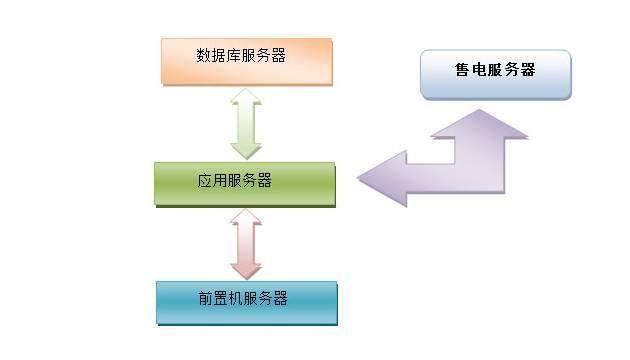
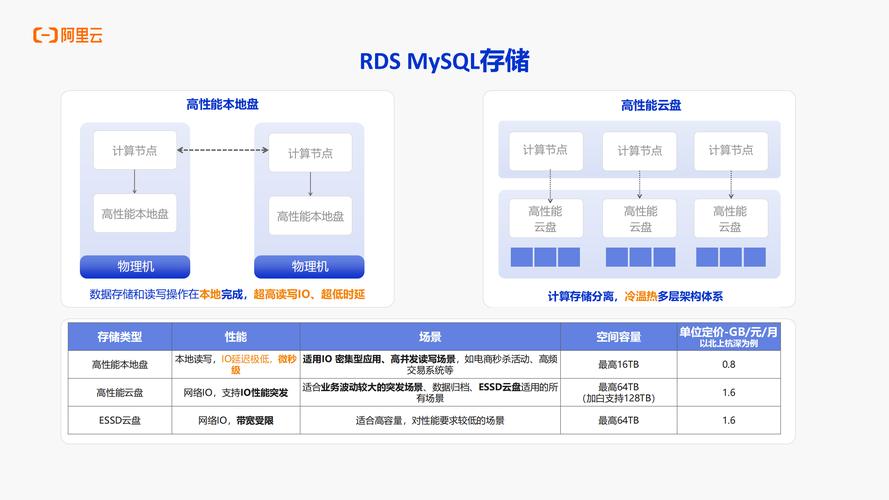
数据处理完成后,存储支持服务决定了数据能否被长期、稳定、高效地利用。建议采用分层存储架构:原始数据层保存采集到的名单文件及原始记录,便于审计和追溯;标准数据层保存经过清洗和标准化后的企业主数据;匹配结果层保存绿色工厂名单与外部数据的关联关系、匹配得分和审核状态;服务层则通过数据库视图、API接口或数据包方式对外提供查询和统计分析能力。对于结构化数据,可使用关系型数据库存储企业主数据和匹配关系;对于非结构化附件和文本材料,可采用对象存储进行保存;对于大规模统计分析,可引入数据仓库或列式存储以提升查询性能。
在服务能力方面,面向第一至十批绿色工厂名单匹配的数据处理和存储支持服务,至少应提供以下功能:一是名单管理,支持按批次、地区、行业、年份等维度检索和导出;二是企业匹配,支持单条匹配、批量匹配和定时匹配;三是数据关联,支持将绿色工厂名单与能耗、碳排放、专利、产值等主题数据连接;四是质量管理,支持匹配结果统计、异常预警和人工校验;五是安全与权限控制,确保企业敏感信息和内部审核记录不被越权访问。
从应用价值看,这一数据处理和存储支持服务能够为政府主管部门、行业研究机构、金融机构和企业自身提供重要支撑。政府部门可据此评估绿色工厂培育成效和区域分布特征;研究机构可开展绿色制造与产业升级的关联分析;金融机构可识别绿色信贷和ESG投资标的;企业则可对照名单查找供应链绿色化机会。与此还应重视数据合规问题,确保企业信息使用符合相关法律法规和授权范围。
第一至十批绿色工厂名单匹配并非简单的表格合并,而是一项涉及多源数据治理、企业实体对齐、匹配算法设计和长期存储服务的系统工程。通过建立规范的数据处理流程、可靠的匹配机制和可持续的存储服务体系,可以显著提升绿色工厂名单数据的可用性和应用价值,为绿色制造研究和政策决策提供坚实的数据基础。
如若转载,请注明出处:http://www.origspot.com/product/16.html
更新时间:2026-10-24 20:12:28